ローカルLLMを触るとき、どのモデルが自分のMacに載るのか、載ったとしてどれくらいの速さで返ってくるのかは、落として動かすまで分かりません。4Bクラスでも1モデル3GB前後あるので、片っ端から試すのは時間もディスクも食います。
llmfit は、そこを事前に見積もるCLIツールです(GitHub 3.5万スター、MIT)。CPU・メモリ・GPUを検出して、8,000件以上のモデルについて「メモリに載るか」と「生成速度(tok/s)」を出します。ただし中身は「メモリ帯域 ÷ モデルサイズ × 係数」の計算で、モデルを実際に動かしているわけではありません。どこまで信用していいのか、手元の M4 MacBook Air 16GB で実測と並べました。
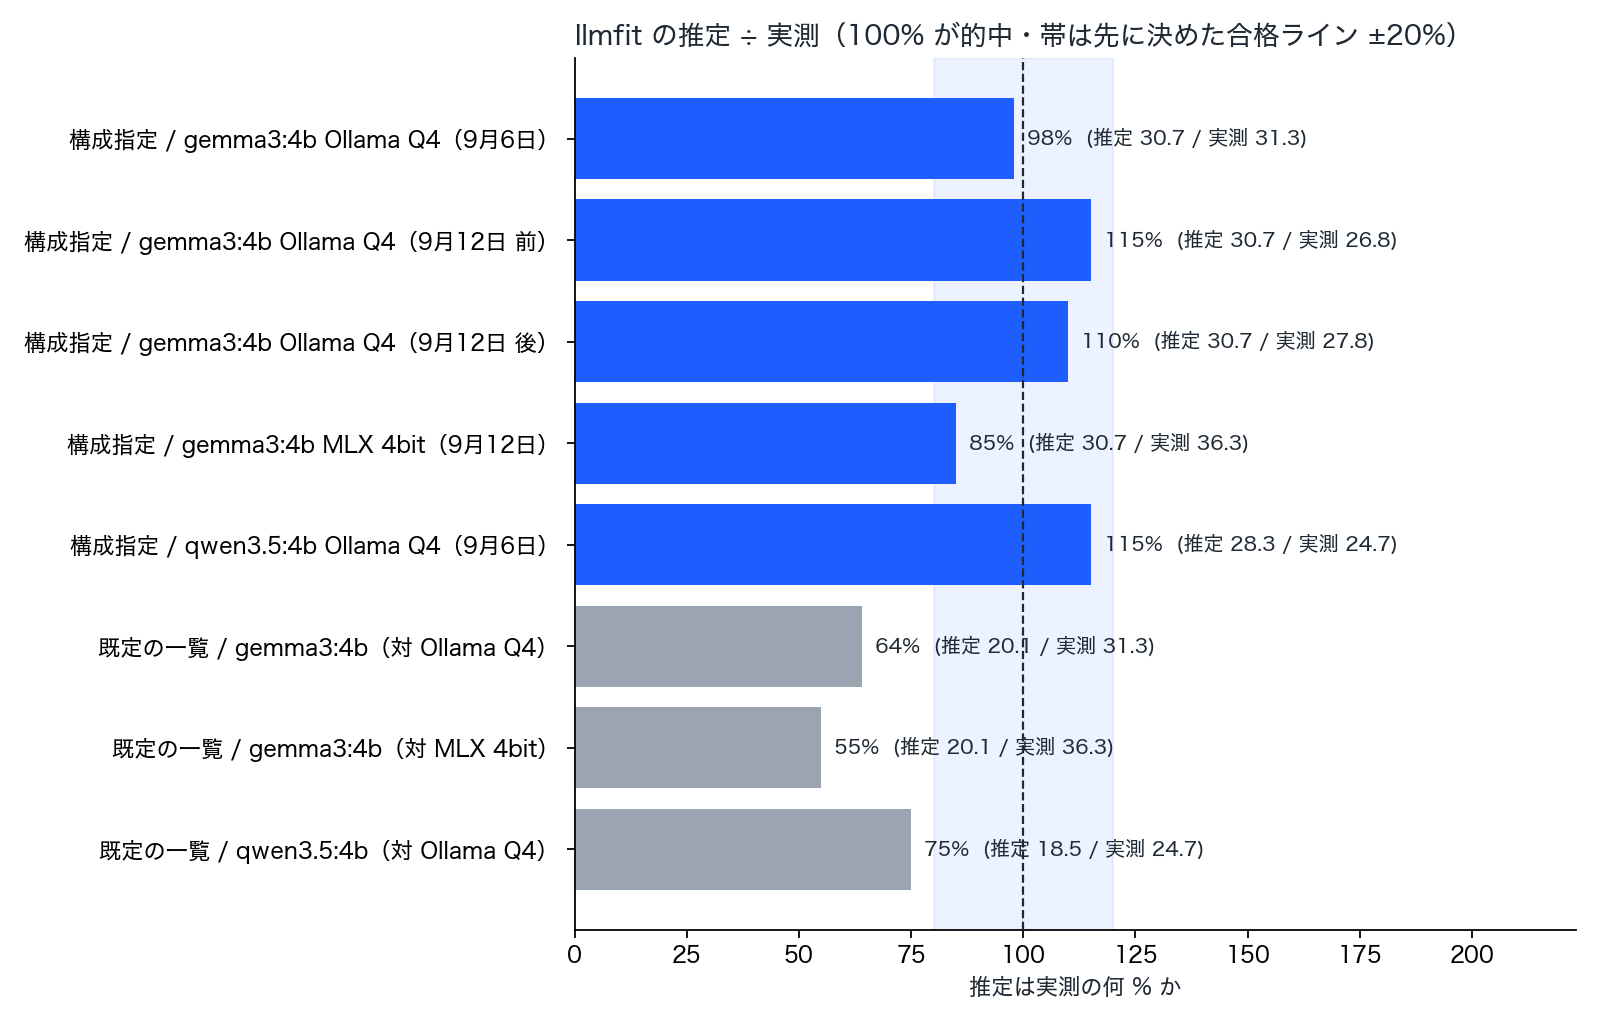
先に結果です。量子化を指定して推定させた5件は、実測との差が最大15%でした。一方、何も指定しない一覧の値は実測の55〜75%で、3〜4割低く出ます。この差は精度の問題ではなく、量子化の前提が違うせいでした。
llmfit が出す数字は2種類ある
同じツールでも、コマンドによって前提が違います。
llmfit fit: 何も指定せず、全モデルの推定を一覧で出す。量子化は llmfit が選ぶllmfit plan: モデル・量子化・コンテキスト長を指定して、1件だけ推定する
比較の基準は測る前に決めました。差が2割以内なら合っているとみなすことにしています。
測り方
llmfit fit --json --no-dashboard
llmfit plan "google/gemma-3-4b-it" --context 4096 --quant Q4_K_M --json
実測は Ollama と MLX の2通り。同じ日本語の指示文を投げ、最大200トークン、温度0、seed=42 で5回動かして中央値を取りました(9月6日の計測だけ3回)。Ollama は /api/generate の eval_count ÷ eval_duration、MLX は mlx-lm の stream_generate が返す generation_tps を使っています。
| 項目 | 値 |
|---|---|
| マシン | MacBook Air(Apple M4・10コア・16GB ユニファイドメモリ)・macOS 26.5 |
| llmfit | 1.1.15(GitHub Releases の arm64 バイナリ) |
| Ollama | 0.33.3 |
| MLX | mlx-lm 0.31.3 / mlx 0.32.2 |
| モデル | gemma3:4b(Q4_K_M・3.11GiB)、qwen3.5:4b(Q4_K_M・3.16GiB)、mlx-community/gemma-3-4b-it-4bit |
Slack も Chrome も Notion も開いたまま測っています。普段の状態で何 tok/s 出るかが知りたかったからです。そのかわり、空きメモリとスワップ使用量を1回ごとに残しました。
量子化を指定した推定は、実測と最大15%差
| 実測した構成 | 推定(plan) | 実測(中央値) | 推定÷実測 |
|---|---|---|---|
gemma3:4b Ollama Q4(9月6日) | 30.7 tok/s | 31.3 tok/s | 98% |
gemma3:4b Ollama Q4(9月12日、MLX の前) | 30.7 tok/s | 26.8 tok/s | 115% |
gemma3:4b Ollama Q4(9月12日、MLX の後) | 30.7 tok/s | 27.8 tok/s | 110% |
gemma3:4b MLX 4bit(9月12日) | 30.7 tok/s | 36.3 tok/s | 85% |
qwen3.5:4b Ollama Q4(9月6日) | 28.3 tok/s | 24.7 tok/s | 115% |
llmfit は Q4_K_M と mlx-4bit に同じ 30.7 tok/s を返します。ランタイムを Ollama から MLX に替えても実測はその前後で、4bit であれば実装の違いは誤差に埋もれました。
メモリ使用量も plan が返します。こちらは3件とも6〜28%多めでした。足りなくなる側には外していないので、載るかどうかの判断には使えます。
| 実測した構成 | 推定(KVキャッシュ込み) | 実測 | 推定÷実測 |
|---|---|---|---|
gemma3:4b Ollama Q4 | 3.53GB | 2.89GB(ollama ps の値) | 122% |
qwen3.5:4b Ollama Q4 | 3.33GB | 3.15GB(同) | 106% |
gemma3:4b MLX 4bit | 3.40GB | 2.65GB(mlx のピーク値) | 128% |
一覧の値が低いのは 8bit 前提だから
fit の値は gemma3:4b が 20.1、qwen3.5:4b が 18.5 tok/s。実測の55〜75%です。
llmfit はメモリに余裕があると品質の高い量子化を選ぶので、このMacでは mlx-8bit で計算します。私が入れているのは Q4_K_M と mlx-4bit なので、そもそも別の構成の数字を見ていたことになります。plan で量子化だけ変えると、こう動きます。
| 指定した量子化 | gemma3:4b | qwen3.5:4b |
|---|---|---|
| Q4_K_M(Ollama の既定) | 30.7 | 28.3 |
| mlx-4bit | 30.7 | 28.3 |
| mlx-8bit(llmfit が選ぶ) | 15.3 | 14.2 |
Ollama を起動していれば llmfit はインストール済みのモデルを検出します。それでも一覧の推定は mlx-8bit のままでした。一覧に並ぶ値は、自分が入れたモデルの速度ではなく、llmfit が勧める構成で動かしたときの速度です。
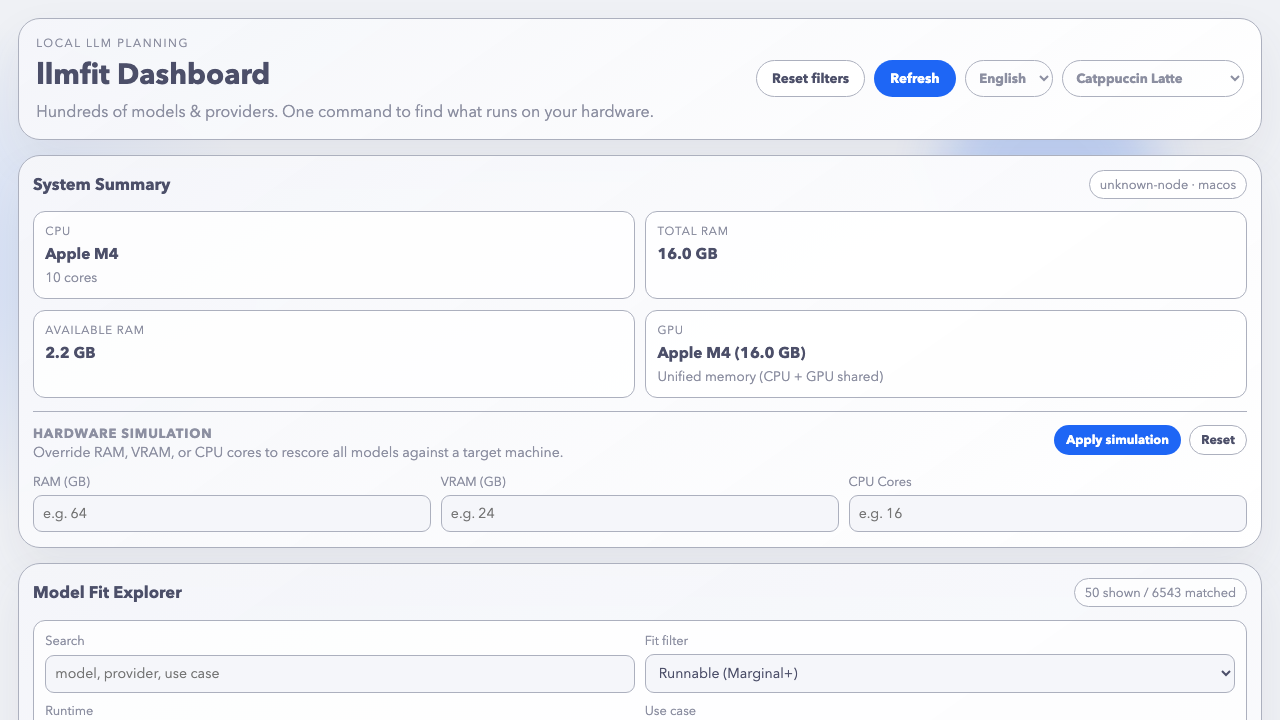
厄介なのは、同じモデルでもコマンドによって値が変わる点です。fit の 20.1 と plan --quant mlx-8bit の 15.3 は比が1.31。これは fit だけが掛けている補正係数(起動時に測ったメモリ帯域から出る1.309)と一致します。Web 画面は補正なしの側なので、比べるときはどれか1つのコマンドに揃えてください。
同じモデルでも、日によって6倍違った
アプリを開いたまま、日を変えて gemma3:4b を測るとこうなりました。
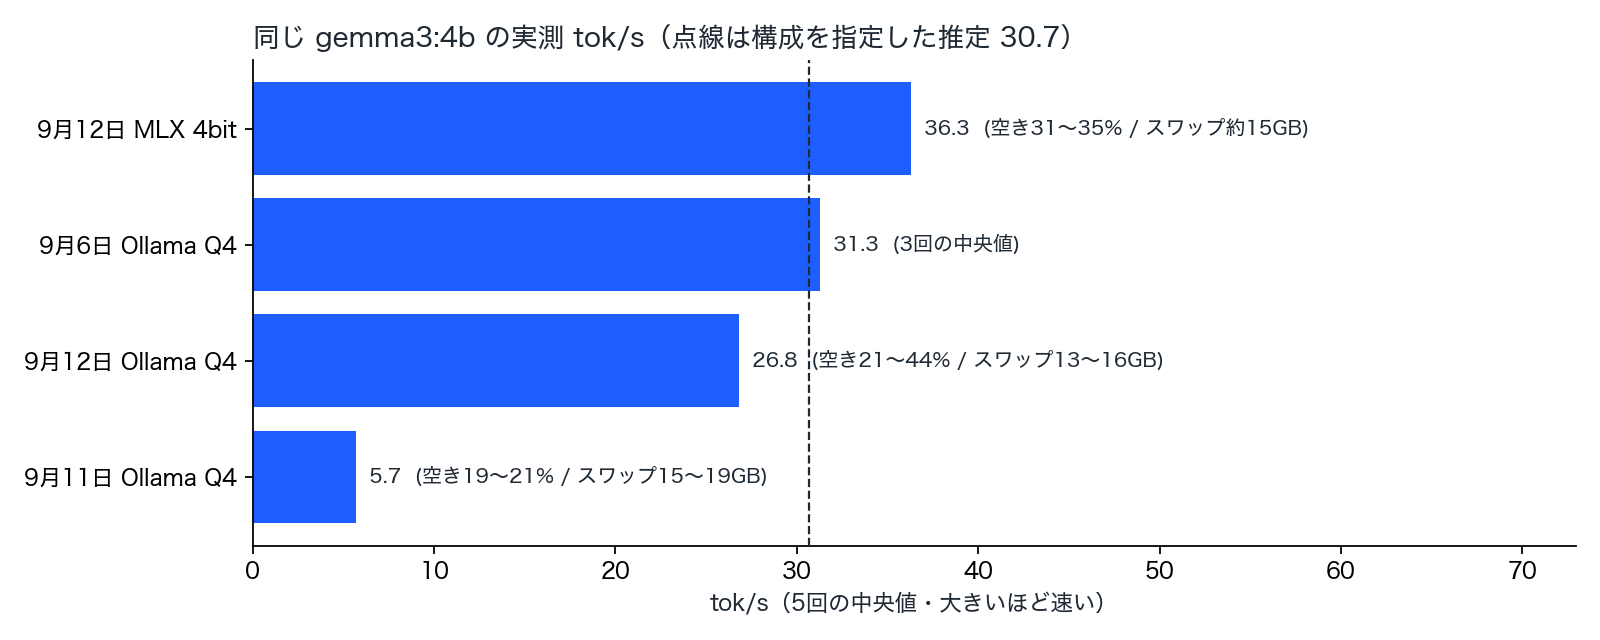
| 計測 | 空きメモリ | スワップ使用量 | 実測(中央値) | 5回の範囲 |
|---|---|---|---|---|
| 9月12日 MLX 4bit | 31〜35% | 約15GB | 36.3 tok/s | 31.9〜37.5 |
| 9月6日 Ollama Q4 | 1.3〜2.4GB(llmfit の表示) | 記録なし | 31.3 tok/s | 31.2〜33.7 |
| 9月12日 Ollama Q4 | 21〜44% | 13〜16GB | 26.8 tok/s | 22.1〜27.9 |
| 9月11日 Ollama Q4 | 19〜21% | 15〜19GB | 5.7 tok/s | 3.8〜8.9 |
9月11日はスワップが19GBまで膨らんでいた日です。ollama ps を見るとモデルは GPU 側に全部載っているのに、初回の読み込みに16〜58秒、生成は5.7 tok/s。ほかの日とは6倍違います。スワップに押されて重みがメモリに留まれず読み直しているのだろう、という見当はつきますが、そこまでは追っていません。
llmfit はその時点のメモリの混み具合を見ていないので、推定の30.7 tok/s は「余裕がある日に出る速度」として読むことになります。
測っていないこと
llmfit が一覧で使う mlx-8bit そのものと、qwen3.5:4b の MLX 実測は試していません。12B以上のモデルもディスクの空きが足りず、13GB の gpt-oss:20b は見送りました。今回の2モデルはどちらもメモリに余裕のあるサイズなので、載るかどうかの境目はまだ確かめられていません。